sentinelK
V2EX  ›  Local LLM

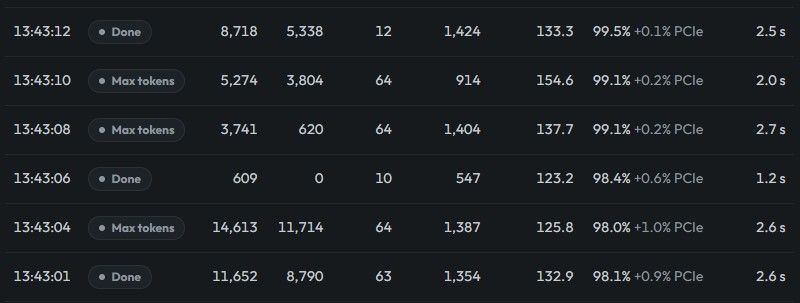
你好 NVFP4: strata-0.1.44.1, qwen3.8-flash-next, rtx pro 5000 48GB + 64GB RAM, decode 130t/s, prefill2600 t/s

  •  
  •   sentinelK · 7 days ago · 1083 views

    如题。

    相较于只有ISTA-DASLab 孤立跑分的 IQ3 系列,nvfp4 有英伟达官方站台,所以其能力会更有说服力。 image.jpeg
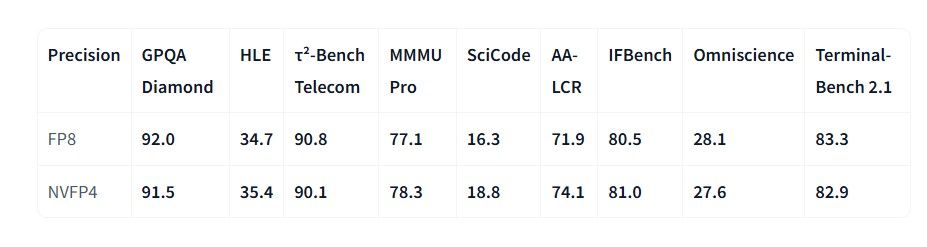
    更何况 nvfp4 并不是全 4bit ,很多参数都保持了全量 bf16 。

    对于 64GB ram + rtx pro 5000 48GB 而言。瓶颈主要是因为专家变大了,导致显存只能放进 13500 个专家,从而专家命中率从 99.7%降低至大概 97.x~99%。 image.jpeg image.jpeg
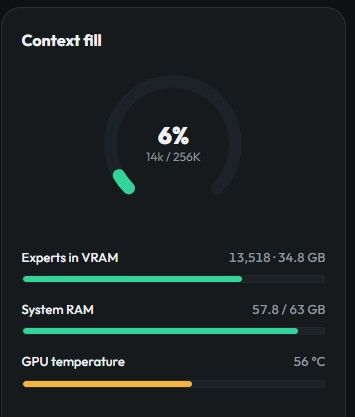
    然后就是因为内存的紧张,所以 Conversation cache 只能维系在 8GB ,4slot 。 image.jpeg
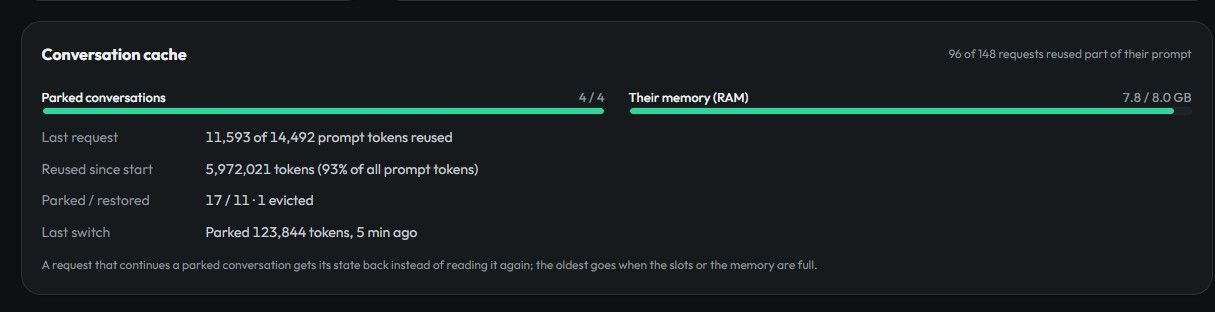
    其他的配置保持不变。 如惯例,贴出我的配置表:

    args": [
      "--pack",
      "C:\\work\\Strata-data\\models\\Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata\\pack",
      "--native",
      "C:\\work\\Strata-data\\models\\Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata\\qwen-nvfp4-gptq-dense.gguf",
      "--native-dense-gguf",
      "C:\\work\\Strata-data\\models\\Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata\\qwen-nvfp4-gptq-dense.gguf",
      "--ple-gguf",
      "C:\\work\\Strata-data\\models\\Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata\\ple-fp8.gguf",
      "--embd-gguf",
      "C:\\work\\Strata-data\\models\\Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata\\token-embd-bf16.gguf",
      "--expert-profile",
      "C:\\work\\Strata\\data\\expert-profile.bin",
      "--expert-cache",
      "auto",
      "--prefill",
      "auto",
      "--spec",
      "4",
      "--mtp",
      "C:\\work\\Strata-data\\mtp\\rt",
      "--max-context",
      "262144",
      "--kv",
      "k8v4",
      "--resident-budget-gib",
      "39",
      "--vision",
      "--vram-reserve-mib",
      "700",
      "--spec-min-p",
      "0.5",
      "--pool-workers",
      "2",
      "--conversation-cache-mib",
      "8192",
      "--conversation-cache-min-tokens",
      "20000"
     ],
    
    8 replies  •  2026-10-22 04:14:55 +08:00
    catazshadow
        1
    catazshadow  
       7 days ago
    这个跟 IQ3 比会明显更聪明吗
    flkaylor19
        2
    flkaylor19  
       7 days ago
    @catazshadow 聪明 不循环
    sentinelK
        3
    sentinelK  
    OP
       6 days ago
    @catazshadow 如果从跑分角度讲,大概提升 5%,从困惑度角度讲降低 50%。

    实操中,比 IQ3_XXS 更少出现雷霆思考。代价就是对于 48 vram + 64ram 来讲,考虑到会话缓存,nvfp4 还是有点太极限了。
    catazshadow
        4
    catazshadow  
       6 days ago via Android
    @flkaylor19 我用 opencode ,iq3 倒是没见过循环
    catazshadow
        5
    catazshadow  
       6 days ago via Android
    @sentinelK 注意力漂移呢,会不会少点
    sentinelK
        6
    sentinelK  
    OP
       6 days ago
    @catazshadow 我是开的 262144 的上下文长度,一般来讲到 220k 的时候已经触发压缩了,所以没见过严重的注意力漂移
    catazshadow
        7
    catazshadow  
       6 days ago
    "--conversation-cache-mib",

    这个现在多卡也能用了
    panghu960
        8
    panghu960  
       1h 42m ago
    同在本地和端侧跑大模型及自托管工具(做过 openmuse-standalone 和离线同传 NoNetPlay ,声明我是开发者),非常认同楼主对 NVFP4 实测的务实总结,特别是「专家命中率」和「会话缓存( Conversation cache )」这两个点,完全切中了工程落地的实际痛点:

    1. 专家命中率与延迟抖动:
    纯跑分和吞吐测试往往只看平均 Decode 速度,但实操中当显存预算把专家池压到 13.5k 左右、命中率从 99.7% 掉到 97~98% 时,最难受的是那 2%~3% 的冷专家加载带来的尾延迟尖刺( Tail Latency )。对于实时交互或 Coding Agent 频繁调用工具的场景,偶尔一次几百毫秒的卡顿体验非常明显。楼主能把注意力漂移和会话压缩的边界( 220k 触发压缩)摸得这么细,参考价值极高。

    2. 会话缓存与多并发权衡:
    在 64G RAM 下把 Conversation cache 压缩到 8G/4slot 确实是当前硬件限制下的最优解了。NVFP4 保留核心权重 BF16 + 敏感层精度的做法,比起激进的极致超低比特量化(如 IQ3_XXS ),确实能极大缓解“雷霆思考”(死循环和逻辑崩溃)。

    非常硬核的实测参数配置,感谢楼主分享!
    About   ·   Help   ·   Advertise   ·   Blog   ·   API   ·   FAQ   ·   Privacy   ·   Solana   ·   936 Online   Highest 6679   ·     Select Language
    创意工作者们的社区
    World is powered by solitude
    VERSION: 3.9.8.5 · 27ms · UTC 21:57 · PVG 05:57 · LAX 14:57 · JFK 17:57
    ♥ Do have faith in what you're doing.